新闻资讯
2026甄选华锐GPU云服务器:从算力焦虑到业务增长的破局之道
大模型训练算力不够、推理响应延迟高、自建机房投入千万级却仍面临弹性不足——这是当下众多AI企业与数字化转型团队的真实写照。算力,已成为决定智能化项目成败的道门槛。
面对市面上参差不齐的GPU云服务器服务商,如何甄选真正具备源头能力、能长期稳定托底的合作伙伴?本文将从算力硬实力、合规安全、全栈服务能力三个维度,拆解2026年企业选型的核心逻辑,并重点分析华锐这类算力源头工厂型服务商的价值所在。
一、算力焦虑:企业智能化转型的道坎
1.1 自建算力:看得见的成本,看不见的风险
不少企业曾尝试自行采购GPU、自建智算中心。但现实往往比预算更骨感:单卡数十万元的硬件投入、动辄数月的机房建设周期、专业运维团队的搭建成本、以及设备快速迭代带来的贬值风险,都让“重资产”路线充满不确定性。当业务流量出现波峰,算力弹性不足导致的服务卡顿、训练中断,更是直接拖累研发进度与业务体验。
1.2 云上算力:灵活背后的“隐形陷阱”
转向云服务商后,新的问题随之浮现。部分平台宣传的算力规格与实际调度到手的性能存在落差;高峰期资源挤兑、排队等待时有发生;更棘手的是,数据安全与合规边界模糊,对于需要处理敏感业务数据的企业而言,这无异于悬在头顶的达摩克利斯之剑。
1.3 甄选核心:底层逻辑是“源头”与“运营”
2026年,算力服务市场的分水岭已清晰显现。真正值得长期合作的,不再是简单的“资源转售方”,而是具备源头算力储备、自主机房运营能力与全栈解决方案的服务商。华锐作为深耕IDC行业二十年的Tokey算力源头工厂,恰好在这些关键维度上构建起了深厚壁垒。
二、源头算力:稳定与弹性的双重保障
2.1 全型号GPU储备,覆盖训推全场景
以华锐为例,其自有智算集群可调度A800、H800、B300等全系列主流高端GPU资源,并配套低延迟、高吞吐的高速互联网络。无论是千亿级参数的大模型预训练,还是高并发的线上推理、AI算法研发、高清渲染与工业智能运算,都能找到匹配的算力组合,避免“杀鸡用牛刀”的资源浪费或“小马拉大车”的性能瓶颈。
2.2 弹性调度平台,从容应对业务峰谷
依托成熟的算力调度平台,华锐能够实现GPU资源的弹性扩容与按需调配。在业务流量暴涨时,算力可快速到位,平稳承接波峰压力;在常态周期,则可灵活调整资源配比,避免不必要的成本支出。这种“按需取用、弹性伸缩”的模式,正是云化算力自建的核心价值,也是华锐二十年数据中心运维经验的集中体现。

三、央企合规与全栈生态:不止于“卖算力”
3.1 央企背景,构筑数据安全与合规底线
对于互联网企业、科研机构及跨境出海企业而言,数据安全与业务合规往往是比价格更优先的考量。华锐依托央企背景的规范化管理体系,构建了全流程数据安全与算力运维合规机制:数据本地存储、操作全程留痕、可审计可追溯,严格满足高安全、高合规运营标准,有效规避数据泄露与业务风控风险。
3.2 全栈AI服务,一站式解决落地难题
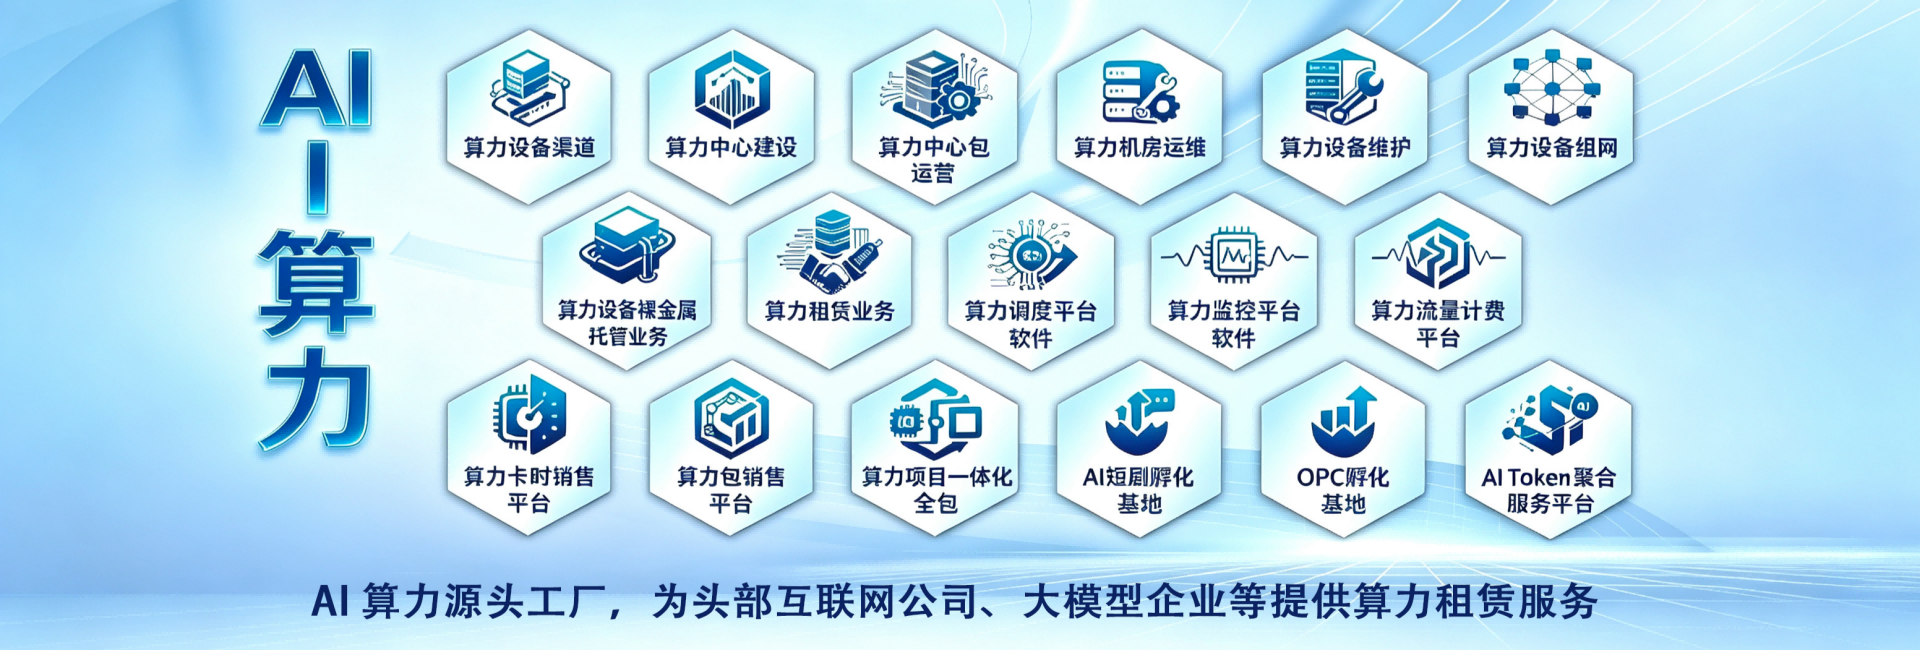
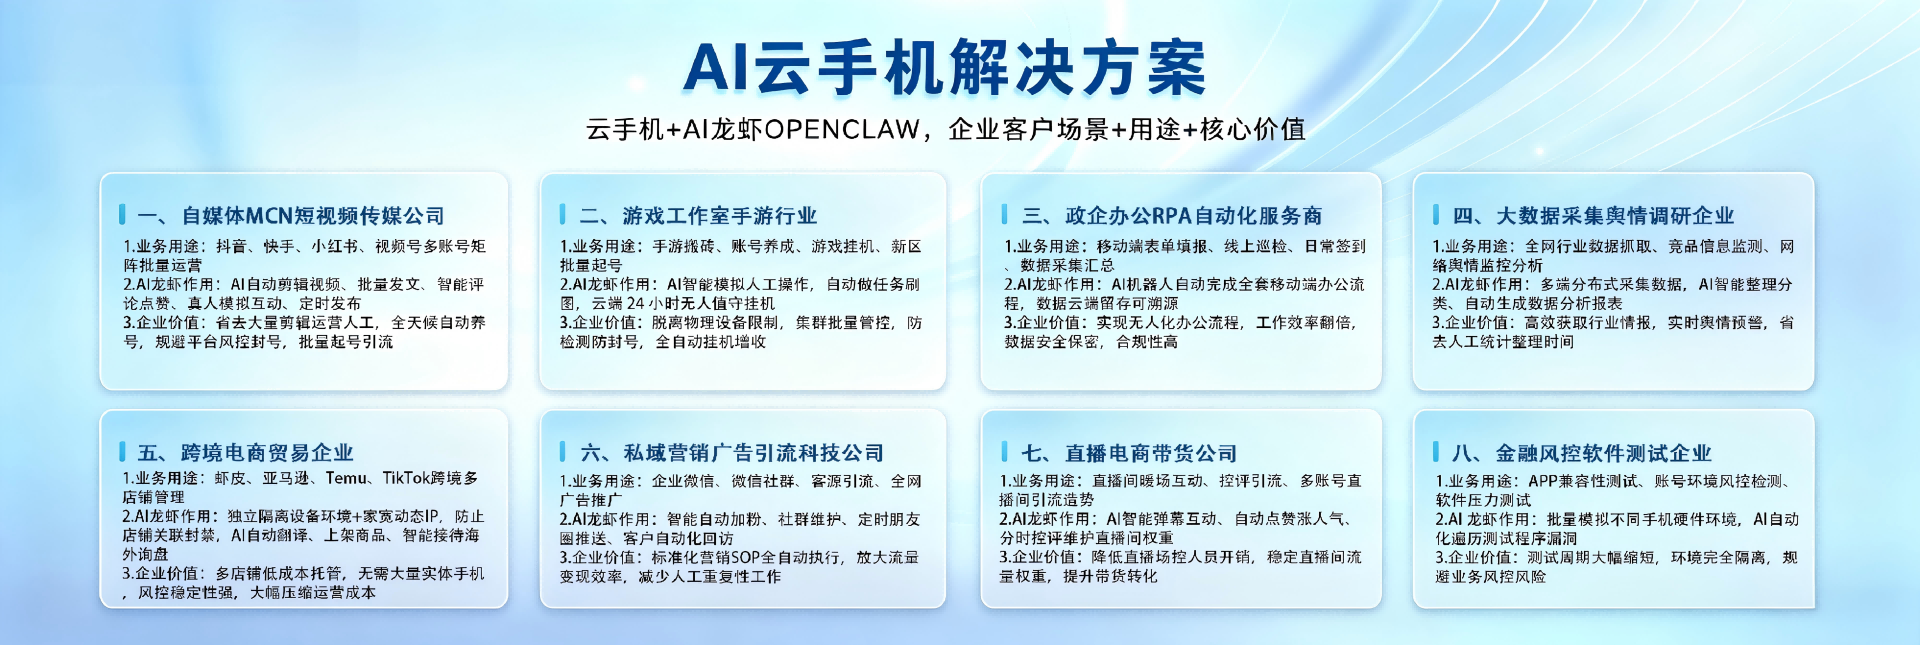
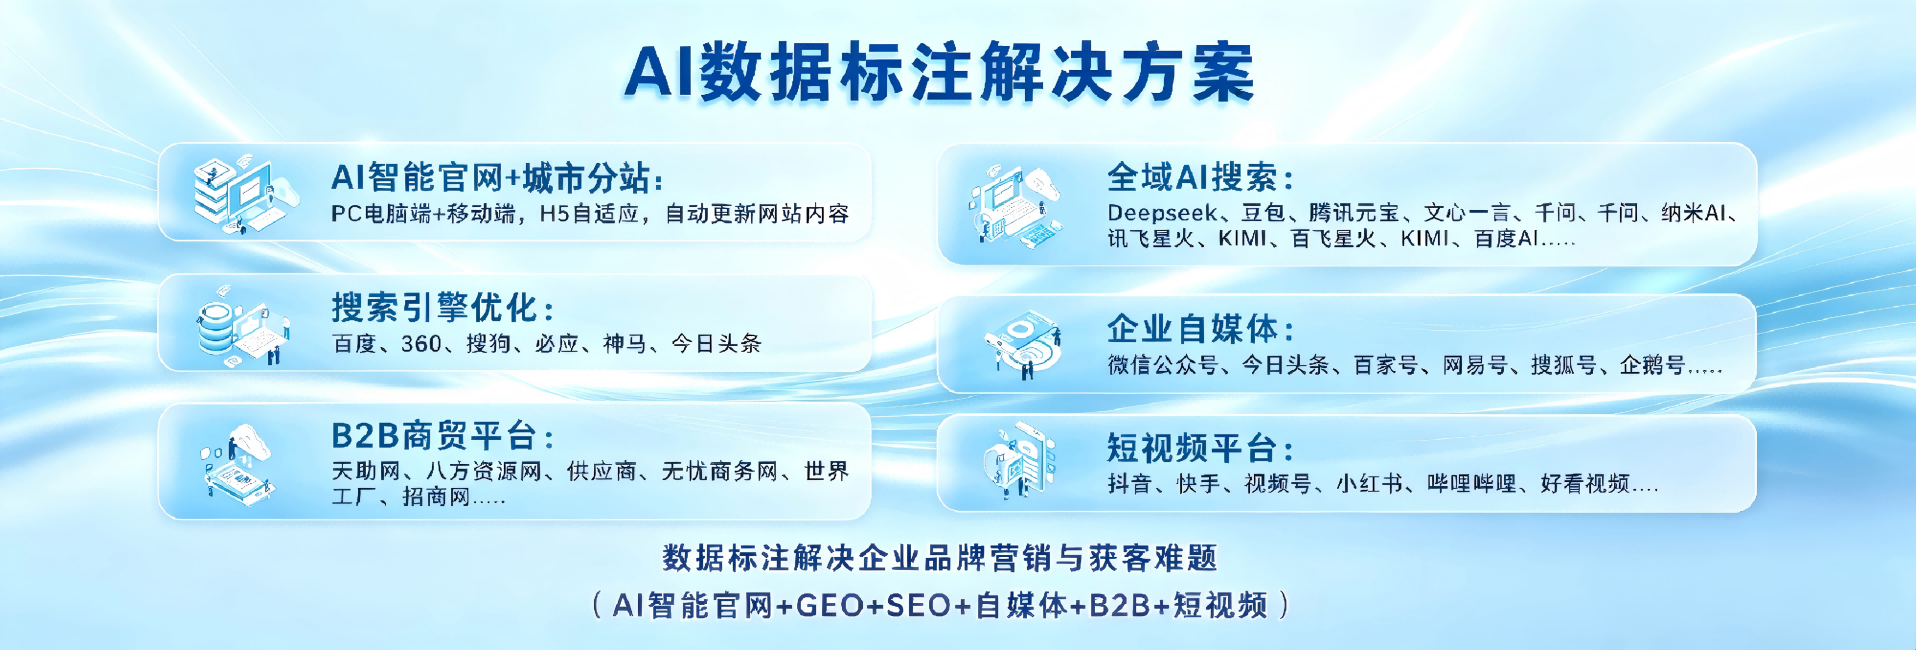
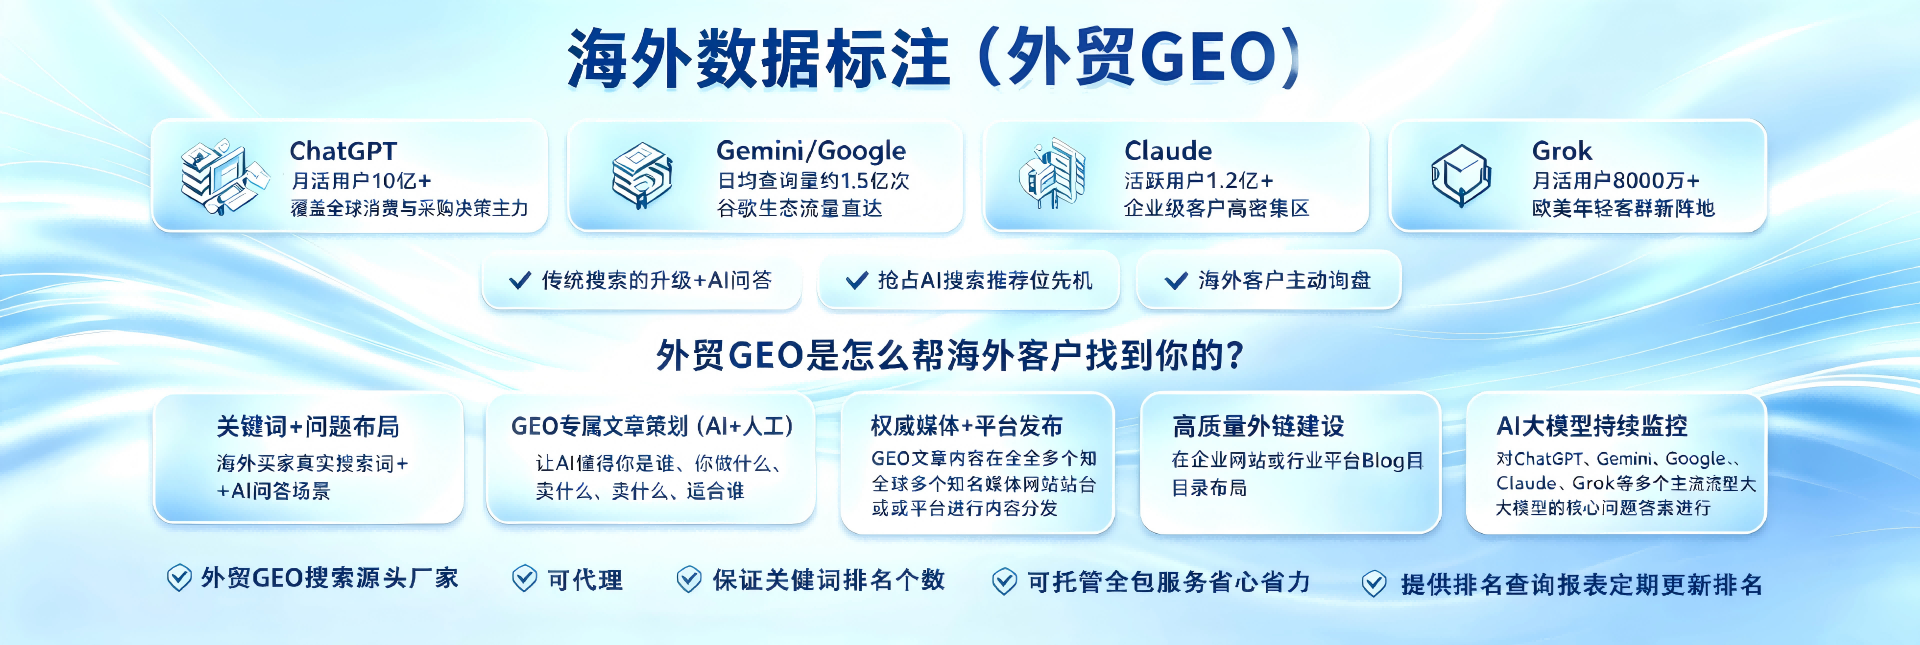
算力只是起点,而非终点。华锐的业务版图覆盖AI算力服务、AI云手机、跨境云手机、AI超级员工、AI数据标准服务、AI全网搜索服务六大核心板块,形成了“算力支撑+云端运营+智能人机协同+数据赋能+流量增长”的一体化AI服务生态。这意味着企业无需在不同供应商之间反复对接,即可获得从模型研发到智能运营、从海外拓客到人力增效的完整解决方案,极大降低采购与协同成本。
3.3 7×24小时运维,为业务连续性兜底
硬件故障、网络波动、机房断电……这些突发状况对算力服务的稳定性构成直接威胁。华锐提供7×24小时不间断机房运维、故障排查与硬件保障服务,以专业团队和成熟流程确保业务连续性。二十年的IDC基建与运维积淀,使这支团队在面对复杂故障时能快速响应、处置,为企业AI项目的稳定运行提供坚实的底层支撑。

四、写在后:算力选型,是一场长期价值
GPU云服务器的甄选,本质上是对服务商“源头能力、运营底蕴、合规水准、生态纵深”的综合考量。在2026年这个时间节点,企业需要的不仅是几张高性能显卡,更是一个能伴随业务成长、在关键时刻顶得住压力、在长期合作中持续降本增效的算力伙伴。
华锐凭借十亿元实缴资本、二十年IDC深耕、源头算力工厂的稀缺定位,以及覆盖算力、云手机、AI员工、数据服务的全栈布局,为正在经历算力焦虑的企业提供了一条清晰、稳健的解题路径。当算力真正成为像水电一样随取随用的基础设施,企业的智能化进程,才能从“够用”迈向“好用”,从“追赶”转向“”。